RomeoLLMTool - Présentation
romeollmtool lance et pilote des modèles de langage (LLM) sur le cluster ROMEO, via Slurm, avec vLLM, SGLang ou llama.cpp (llama-server).
État du projet
romeollmtool est encore en préproduction. Les sources seront prochainement ouvertes sur RomeoGIT.
Accès
L'outil n'est accessible que depuis le réseau de l'URCA, ou via son VPN. Depuis l'extérieur, le plus simple est un pont SSH entre votre machine et le nœud de connexion utilisé :
ssh -L 11361:localhost:11361 <identifiant>@romeo1.univ-reims.fr
Remplacez le port par celui donné par romeollmtool gateway start (ou
gateway status), et romeo1 par le nœud de connexion effectivement
utilisé. Le pont ouvert, utilisez http://localhost:11361/v1 depuis votre
machine, avec la même clé API (romeollmtool gateway show-key).
En cas de problème, ouvrez un ticket sur le système de support de ROMEO.
Ce que l'outil fait
- un catalogue de modèles vérifiés, partagé entre tous les utilisateurs
- des fiches personnelles pour lancer vos propres modèles et réglages
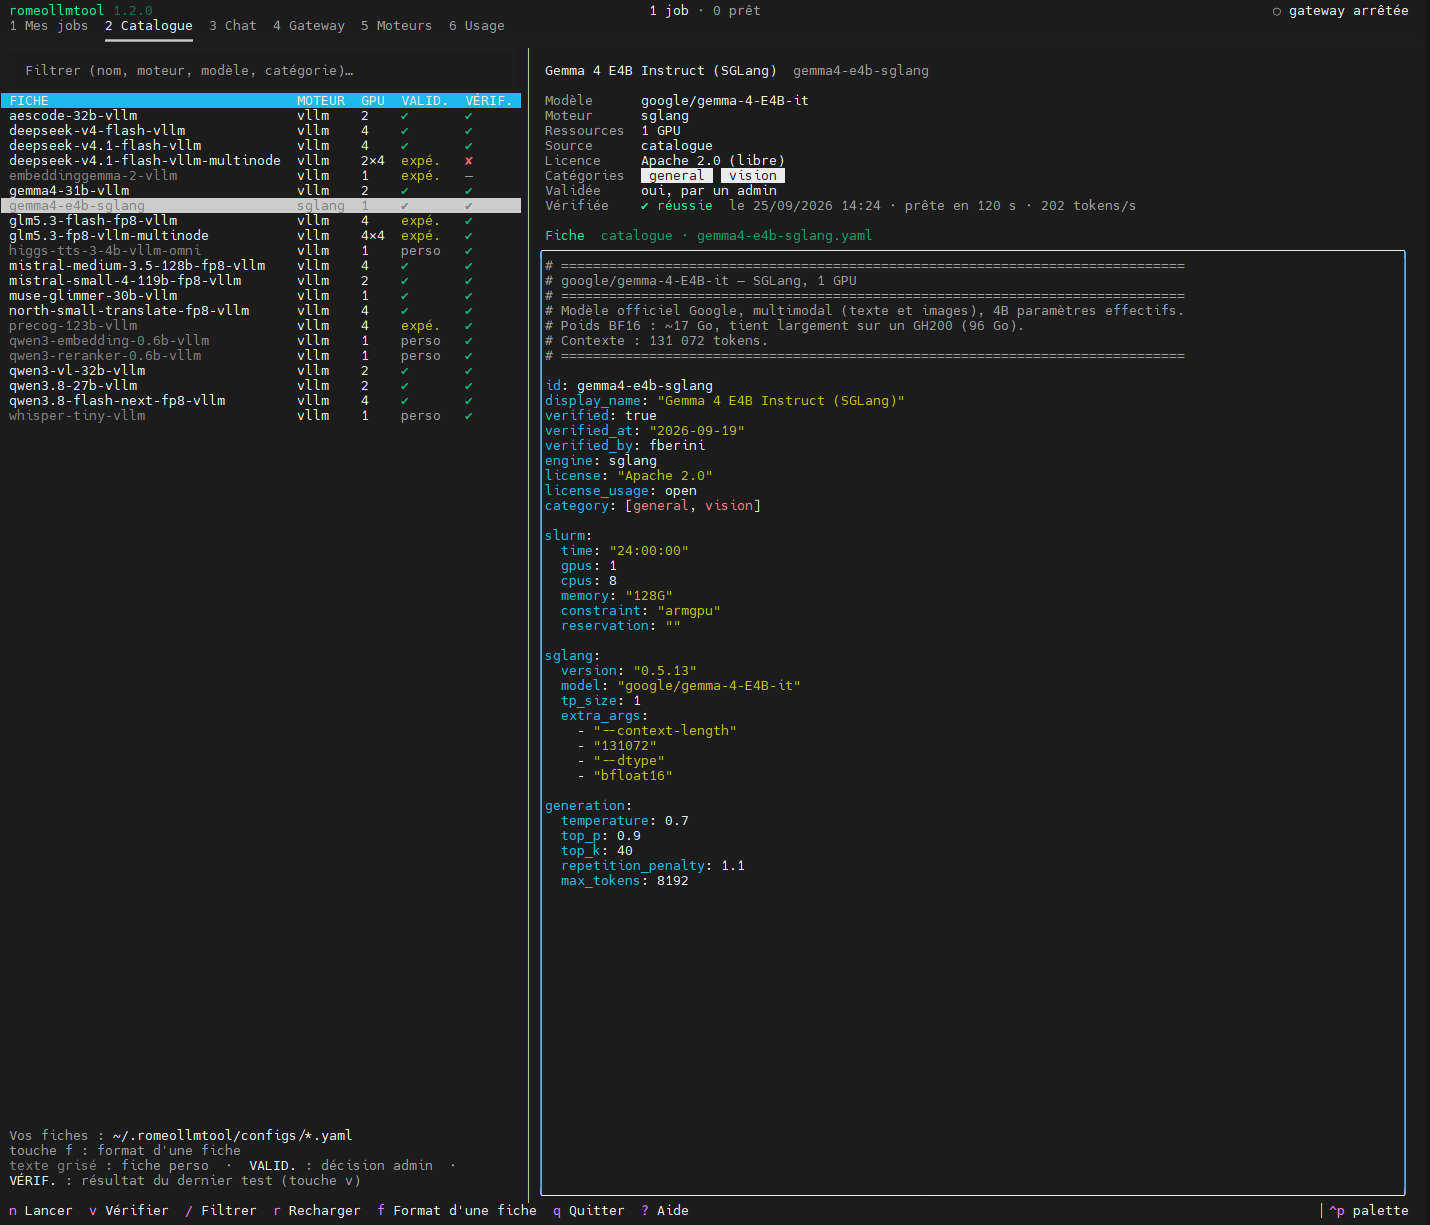
- le lancement et la surveillance d'un modèle en une commande, ou depuis l'interface terminal
- une gateway persistante compatible avec l'API OpenAI : une URL et une clé pour tous vos modèles lancés
- un chat intégré pour tester un modèle sans écrire de code
- une vérification automatique d'une fiche (
verify) avant de s'en servir au quotidien
Deux façons de l'utiliser
romeollmtool, sans argument, ouvre l'interface terminal : voir Interface terminal.- chaque action de l'interface existe aussi en sous-commande : voir Ligne de commande.
Les deux appellent le même code : rien ne diffère entre elles, sauf la
présentation. Choisissez selon votre confort : aucune des deux n'est plus
complète que l'autre, hormis l'administration du catalogue partagé, réservée
à une commande à part (romeollmtool-admin), destinée aux administrateurs du
cluster.
Vocabulaire
| Terme | Sens |
|---|---|
| fiche | fichier YAML qui décrit un modèle et comment le servir. Voir Écrire une fiche. |
| catalogue | fiches partagées entre tous les utilisateurs, proposées par merge request, vérifiées puis validées par un administrateur. |
| fiche perso | votre propre fiche, dans ~/.romeollmtool/configs/. Peut compléter une fiche du catalogue ou être autonome. |
| moteur | le serveur d'inférence qui fait réellement tourner le modèle : vLLM, SGLang ou llama.cpp. Voir Moteurs. |
| job | l'exécution Slurm d'un modèle lancé à partir d'une fiche. |
| gateway | proxy persistant, compatible OpenAI, qui donne accès à tous vos modèles lancés par une seule URL et une seule clé. Voir Utiliser l'API. |
| vérifier | lancer un vrai job, le tester (réponse, streaming, vision selon le cas), l'arrêter, et écrire un rapport (romeollmtool verify). |
Pour aller plus loin
- Interface terminal : l'interface qui s'ouvre sans argument
- Ligne de commande : toutes les sous-commandes
- Écrire une fiche : format, fiche perso, licences, catégories
- Moteurs : vLLM, SGLang, llama.cpp, variantes, moteur perso
- Utiliser l'API : intégrer un modèle servi dans un autre outil